我刚进基层法院那会,九十年代末,全院刚换上第一套电脑办案系统。年底归档找案子,输入案号敲回车,屏幕就转圈圈,十分钟出不来结果。技术科的小伙子蹲在服务器旁边挠头,说案子才十万出头,怎么就跑不动了。
最早的“数据库”,全在档案室的木柜子里
说起来,早几百年县衙断案,存案卷也有自己的一套法子,按年份堆,按县分块,真要找个十年前的旧案子,得让差役搬一下午柜子,翻得灰头土脸才找着。这就跟没优化的数据库一个样,全靠堆,没规划。
民国时候法院改了规矩,把民事刑事分开,再按原告姓氏笔画排索引,找起来快了点,但架不住案子越来越多,到后期南京政府的最高法院,调一份旧卷还是得等三五天。
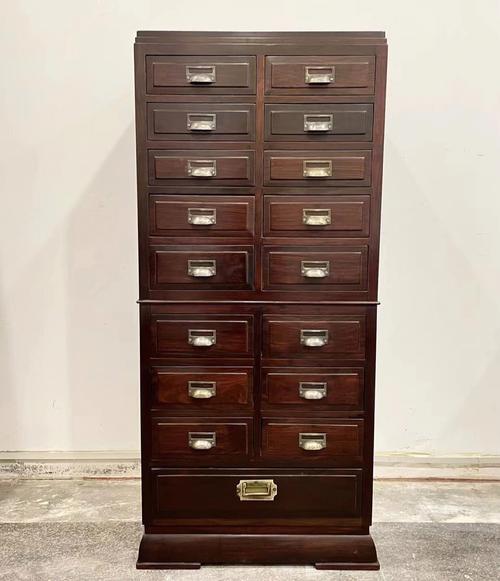
说实话,那时候的人也没想到,几百年后所有案卷都能塞进一个比抽屉还小的服务器里,更没想到数据多了,还会卡。
数据库结构优化,说白了就是给案卷找对地方放
当年我们那套老系统卡成狗,最后请了省里的技术专家来看,专家瞅了一眼结构,直接笑了。说你们心真大,所有信息全塞一张表里,原被告名字、地址、庭审记录、判决原文全堆一块,这不卡才怪。
专家说的优化,说白了就是拆。把原被告的基础信息单独拆出一张表,给身份证号加个索引,把案件流程信息放一张表,判决文书放一张表,以后找案子,先搜案件表拿到案号,再去其他表调对应的信息,比之前扫全表快了几十倍。
不过话说回来,我后来接触过不少做数据库的年轻人,十个有八个图省事,刚开始做的时候觉得数据少,怎么堆都行,反正跑的动。等用户上来了,数据上百万千万了,卡的打开页面都要半分钟,才想起要优化,那时候改结构,不比重新做一遍省事多少,还容易丢数据。
我前两年帮一个做法律科普的朋友改他的案例库,他就是把所有用户咨询记录都塞一张表,一百八十万条数据,搜“离婚财产分割”要等七八秒,优化完结构拆分加索引,现在几十毫秒就出结果,他当时差点给我送锦旗。真的,结构不对,累死白费。
老法官攒的几个数据库结构优化土办法
我干了十几年法官,管了快十年档案,后来又跟技术打交道久了,总结了几个实操的法子,不用啥高深技术,照着做就能解决八成问题。
1. 冷数据尽早拆分出去。五年甚至十年前的旧数据,没人天天查,单独存去低成本的存储,别跟常用的热数据挤一块占资源。
2. 常用搜索字段一定要加索引。就像我们找案子肯定先搜案号或者当事人名字,这俩地方不加索引,等于让你翻遍整个档案室找一张纸。
3. 相同信息别重复存储。同一个当事人的信息,每个案子都存一遍,改一次信息要改几百条,不仅占空间还容易出错,单独整个表不香吗。
4. 垃圾数据定期清理。测试留下的脏数据、用户已经删除的草稿数据,搁那占地方不说,还拖慢查询速度,半年清一次比啥都强。
现在很多人吹什么分布式什么云原生,说的天花乱坠,其实核心逻辑没变,和我们整理档案室是一个道理。你得知道你平时怎么用,就怎么放。啥都往一块堆,刚开始看起来省事,后面有的是罪受。对吧。
